हिंदी Markdown से PDF: संयुक्ताक्षर और मात्राएँ सही रखते हुए
छोटा जवाब
MarkPDF हिंदी टेक्स्ट को Noto Sans Devanagari फ़ॉन्ट में दिखाता है, और क्षमा, ज्ञान, श्रीमान, स्वास्थ्य जैसे संयुक्ताक्षर PDF में भी ठीक वैसे ही जुड़े रहते हैं जैसे प्रीव्यू में। Markdown पेस्ट करें; देवनागरी पहचानते ही फ़ॉन्ट अपने-आप लोड होता है। फिर PDF डाउनलोड करें।
कई PDF कन्वर्टर में हिंदी क्यों टूटती है
देवनागरी लिखने के लिए "shaping" ज़रूरी है: लगातार आने वाले व्यंजन मिलकर संयुक्ताक्षर बनाते हैं, और इ की मात्रा (ि) जिस व्यंजन के बाद टाइप होती है उससे पहले दिखती है। जो टूल हर अक्षर को अलग-अलग रखता है, या ऐसा फ़ॉन्ट इस्तेमाल करता है जिसमें देवनागरी नहीं है, वहाँ हलंत दिखता है, मात्रा ग़लत जगह आती है या ख़ाली बॉक्स बनते हैं।
MarkPDF हर शब्द ब्राउज़र के अपने टेक्स्ट इंजन से बनाता है, इसलिए PDF वही दिखाता है जो स्क्रीन पर है। हमने क्षमा, त्रिकोण, ज्ञान, श्रीमान, द्वार, स्वास्थ्य, कृष्ण और हृदय को ब्राउज़र की रेंडरिंग से मिलाकर जाँचा है।
Pandoc/LaTeX में टूटे संयुक्ताक्षर: जाँच और समाधान
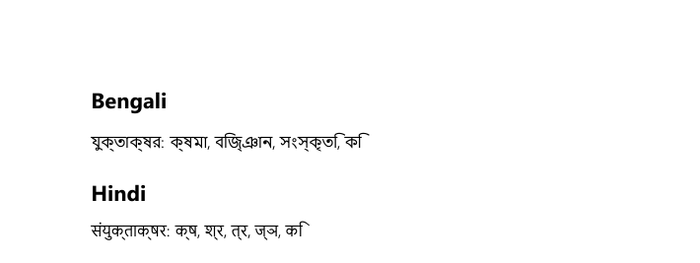
-V mainfont="Nirmala UI" के साथ Pandoc 3.5 + xelatex: क्ष, ज्ञ हलंत के साथ अलग हो गए, और ि की मात्रा व्यंजन के बाद आई। lualatex में भी (Renderer=HarfBuzz के साथ भी) यही नतीजा।वजह: fontspec डिफ़ॉल्ट रूप से लैटिन स्क्रिप्ट मानता है, इसलिए फ़ॉन्ट के देवनागरी shaping नियम चालू नहीं होते। समाधान (जाँचा हुआ): स्क्रिप्ट साफ़ बताएँ।
pandoc hi.md -o hi.pdf --pdf-engine=xelatex \n -V mainfont="Noto Sans Devanagari" \n -V mainfontoptions="Script=Devanagari"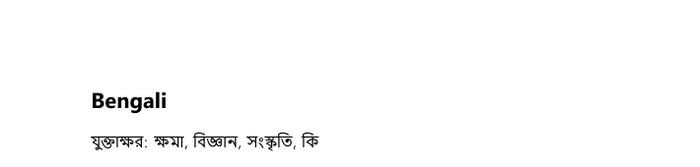
Script=Devanagari से यही नतीजा मिलता है)।एक हिंदी नमूना रिपोर्ट से आज़माएँ
हिंदी नमूना खोलेंकैसे बदलें
- कन्वर्टर खोलें और अपना हिंदी Markdown पेस्ट करें, या कोई
.mdफ़ाइल खींचकर छोड़ें। - देवनागरी अपने-आप पहचानी जाती है और Noto Sans Devanagari लोड होता है।
- प्रीव्यू देखें और PDF डाउनलोड बटन दबाएँ।
एक ही डॉक्यूमेंट में हिंदी और अंग्रेज़ी मिलाकर लिख सकते हैं; देवनागरी अंक (०१२३४५६७८९) भी सही दिखते हैं।
सवाल-जवाब
क्या मेरा डॉक्यूमेंट अपलोड होता है?
नहीं। सारा काम आपके ब्राउज़र में होता है; MarkPDF आपका टेक्स्ट कभी नहीं देखता।
क्या एडिटर में सीधे हिंदी टाइप कर सकते हैं?
हाँ, किसी भी हिंदी कीबोर्ड या इनपुट टूल से (जैसे Google Input Tools, या Windows/Android का हिंदी कीबोर्ड)।
क्या एक्सपोर्ट किए गए PDF में टेक्स्ट सिलेक्ट होता है?
हाँ, "PDF डाउनलोड (टेक्स्ट)" से टेक्स्ट सिलेक्ट और सर्च हो सकता है। "जल्दी डाउनलोड (इमेज)" पेजों को इमेज के रूप में सेव करता है, तब टेक्स्ट सिलेक्ट नहीं होता। दोनों में संयुक्ताक्षर प्रीव्यू जैसे ही दिखते हैं।