Markdown 转 PDF 中文乱码、方块字(豆腐块)怎么解决
简短回答
PDF 里的中文变成 □□□ 方块,几乎都是因为导出时用的字体不包含中文字形;变成“大家”这类乱码,则是文件编码被错当成了别的编码。最省事的办法:把 Markdown 粘贴到 MarkPDF,选择“Noto Sans 简体中文”字体后下载 PDF,字体和编码都由浏览器处理好。
方块字和乱码是两种不同的问题
项目周报:本周完成了用户注册流程
- 方块 □ / 豆腐块:文字本身没错,但渲染用的字体里没有这个字的字形,只能画一个“缺字”方块。常见于默认只带西文字体的转换工具、服务器上没装中文字体的 Linux 环境。
- 乱码(如 `大家` 或 `锟斤拷`):文件是 UTF-8,却被当成 Latin-1、GBK 等其他编码读取。和字体无关,换字体也解决不了。
字符变成空白:在 Pandoc 中复现
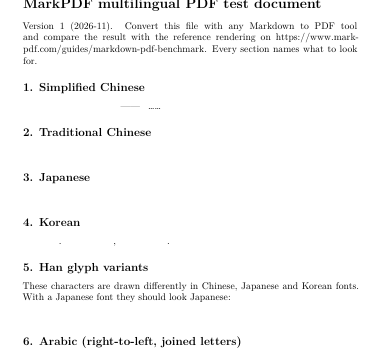
有的工具会把缺失的字显示成方块;LaTeX 引擎则直接留空,只在日志里写一条 “Missing character” 警告。两者原因相同:没有选到包含这些字形的字体。
用一份中文示例试试,看看导出效果
打开中文示例各工具的修法
| 工具 | 修法 | 是否实测 |
|---|---|---|
| Pandoc(pdflatex) | 改用 xelatex:--pdf-engine=xelatex -V CJKmainfont="…",详见 Pandoc 报错页 | 是 |
| Pandoc(xelatex / lualatex) | 加上 -V CJKmainfont="<含对应语言字形的字体>";韩文需要含韩文字形的字体 | 是 |
| md-to-pdf、VS Code Markdown PDF(Chromium) | 在机器上安装中日韩字体(Debian/Ubuntu:fonts-noto-cjk),或在自定义样式表中设置 font-family | md-to-pdf 在 Windows 上使用系统字体显示正常;Linux 的修法为常见做法,未在此实测 |
| Obsidian(内置导出) | 用 CSS 片段强制指定中文字体(见 Obsidian 论坛) | 未实测 |
| Typora | 在主题 CSS 的 font-family 中加入中文字体 | 未实测 |
在 MarkPDF 中导出不乱码的中文 PDF
- 打开 转换器,把 Markdown 粘贴进编辑器,或者直接把
.md文件拖进去。 - 点击右上角 ⚙ 设置,字体选择“Noto Sans 简体中文”(繁体内容选“Noto Sans 繁体中文”)。
- 在右侧预览确认文字显示正常后,点击“下载 PDF”。
转换全部在浏览器里完成,文件不会上传。浏览器按 UTF-8 读取 .md 文件,所以编码问题也一并避免了。
如果坚持用其他工具,可以这样排查
- 确认
.md文件保存为 UTF-8 编码(VS Code 右下角可以查看和切换编码)。 - 在导出工具的样式或主题里,把
font-family设为包含中文的字体,例如"Noto Sans SC", "Microsoft YaHei", "PingFang SC"。 - Linux 服务器上导出时,先安装中文字体,例如 Debian/Ubuntu 的
fonts-noto-cjk软件包。 - Pandoc 用默认的 pdflatex 时不支持中文,需要改用 xelatex 并指定中文字体,详见 Typora、Pandoc、VS Code 中文字体问题。
常见问题
为什么网页上显示正常,导出 PDF 就变成方块?
网页由浏览器用系统字体补全缺失的字形,而很多导出工具只嵌入固定的西文字体,没有中文字形就会画方块。MarkPDF 导出时使用和预览相同的字体,预览正常,PDF 就正常。
日文、韩文也会出现同样的问题吗?
会,原因相同。在 MarkPDF 中选择“Noto Sans 日文”或“Noto Sans 韩文”字体即可。
导出的 PDF 能复制里面的文字吗?
可以。使用“下载 PDF(文字版)”时,PDF 中的文字可以选中、复制和搜索;“快速下载(图片版)”则把页面保存为图片,文字不能选中。
需要安装字体或注册账号吗?
都不需要。字体按需从 Google Fonts 加载,网络不可用时会使用系统自带的中文字体。