PDF で日本語の漢字が中国語の字形になる原因と直し方
要点
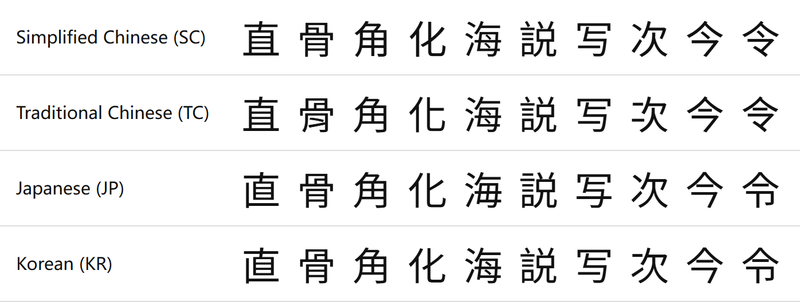
日中韓の漢字の多くは同じ Unicode 符号位置を共有していますが、地域ごとに字形が異なるものがあります。日本語の文書に中国語フォントが使われると、漢字が中国語の字形で表示されます。文書の言語に合ったフォントを指定するか、lang="ja" で言語を明示すれば直ります。
症状
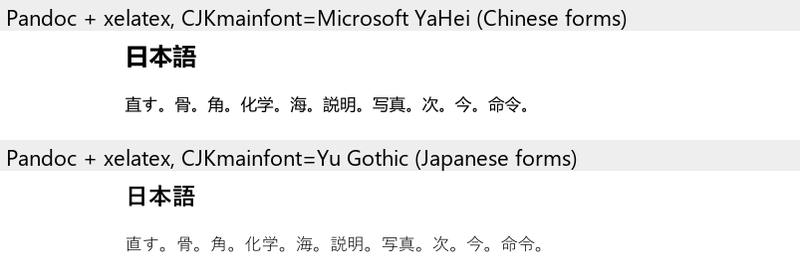
CJKmainfont="Microsoft YaHei"(中国語の字形)と "Yu Gothic"(日本語の字形)。原因
Unicode ではこれらの漢字が統合されているため、文字コードだけでは地域の字形が決まらず、フォントが字形を決めます。文書に言語情報がないと、ツールは最初に見つかった CJK フォント(中国語環境では中国語フォント、または文書全体に指定されたフォント)を使います。
日本語フォントで日本語のサンプルを開く
日本語サンプルを開く各ツールでの対処法
- Pandoc + xelatex:日本語用フォントを指定します。例:
-V CJKmainfont="Yu Gothic"(Windows)、"Hiragino Sans"(macOS)、"Noto Sans CJK JP"。検証:Microsoft YaHei から Yu Gothic に変えると、上の図のとおり日本語の字形になりました。 - HTML / Chromium 系ツール(md-to-pdf で検証。VS Code の Markdown PDF と Typora も Chromium/Electron ベースですが未検証):言語を指定します。
<span lang="ja">…</span>や<html lang="ja">があると Chromium は日本語フォントを選びます。md-to-pdf ではテストファイルのlang="ja"の行が日本語の字形で出力されました。font-familyの先頭に日本語フォントを置く方法もあります。 - 複数言語が混在する文書:言語ごとに
langを付けます(LaTeX では言語ごとにフォントファミリーを分けます)。
日本語の段落:<span lang="ja">直 骨 角 化</span>
中文段落:<span lang="zh-CN">直 骨 角 化</span>
MarkPDF では
⚙ 設定でフォントを「Noto Sans 日本語」にしてください。lang="ja"・lang="ko"・lang="zh-TW"・lang="zh-CN" を付けた部分は、プレビューでも 2 種類の PDF でも、自動的にその地域の Noto フォントに切り替わります。
よくある質問
Unicode の不具合ですか?
いいえ。漢字の統合は意図された仕様で、地域の字形は言語タグとフォントで決まります。
どの漢字が違いますか?
多くは細かな画の違いです。直・骨・角・化・海・令・次・写・今などは分かりやすい例です。一つひとつは小さな違いでも、読み手にはすぐ分かります。
一つのフォントで全地域の字形を出せますか?
Noto Sans CJK / 源ノ角ゴシックのような汎 CJK フォントには全字形が入っていますが、正しい字形を選ぶには言語タグ(または地域別のフォント名)が必要です。